Nếu bạn từng phải ngồi soi từng dòng Markdown sau khi OCR một file PDF scan, bạn sẽ hiểu cảm giác nghi ngờ kết quả. OCR truyền thống trả về text, đúng sai lẫn lộn, không có tín hiệu nào cho biết chỗ nào đáng tin. MiniCPM-OCR của OpenBMB giải quyết đúng cái đau đó, theo hai hướng: một model parse tài liệu, và một model chấm điểm kết quả parse.
Repo này làm gì, cụ thể
OpenBMB/MiniCPM-OCR gồm hai model riêng biệt, không phải một con model gộp chung.
MiniCPM-OCR 1.0 (1.3B tham số) là model OCR chuyên dụng đầu tiên trong họ MiniCPM-V/o. Nó parse tài liệu tiếng Trung và tiếng Anh, có cả PDF. Phạm vi nhận dạng: text, bảng, công thức, biểu đồ, con dấu, và trích xuất thông tin có cấu trúc (KIE). README nói rõ nó xử lý được ảnh scan, ảnh chụp, trang bị cong, trang bị nghiêng, và cả tài liệu chụp lại qua màn hình.
MiniCPM-OCR Jev (2B tham số) làm việc khác hẳn: đưa vào một ảnh và kết quả OCR tương ứng, nó trả về điểm chất lượng từ 0 đến 1. Điểm này ở mức vùng (region level), tức là nó chỉ ra vùng nào đáng tin, vùng nào cần người review. Nó hoạt động với nhiều parsing model khác nhau, không chỉ model của OpenBMB.
Vấn đề nó giải: pipeline OCR hiện tại thường phải chọn giữa “nhanh nhưng phải review nhiều” và “chậm nhưng chính xác”. Jev cho phép đặt ngưỡng, tự động lọc vùng tin cậy, chỉ đẩy phần nghi ngờ cho người kiểm tra. Đó là lý do repo có chữ “correctness assessment” trong mô tả gốc.
Vì sao đang được chú ý
Repo tạo ngày 27/10/2026, cập nhật ngày 30/10/2026, và đã có 547 sao. Ba ngày, 547 sao, với một repo OCR chuyên dụng thì con số này nói lên nhu cầu thật của thị trường.
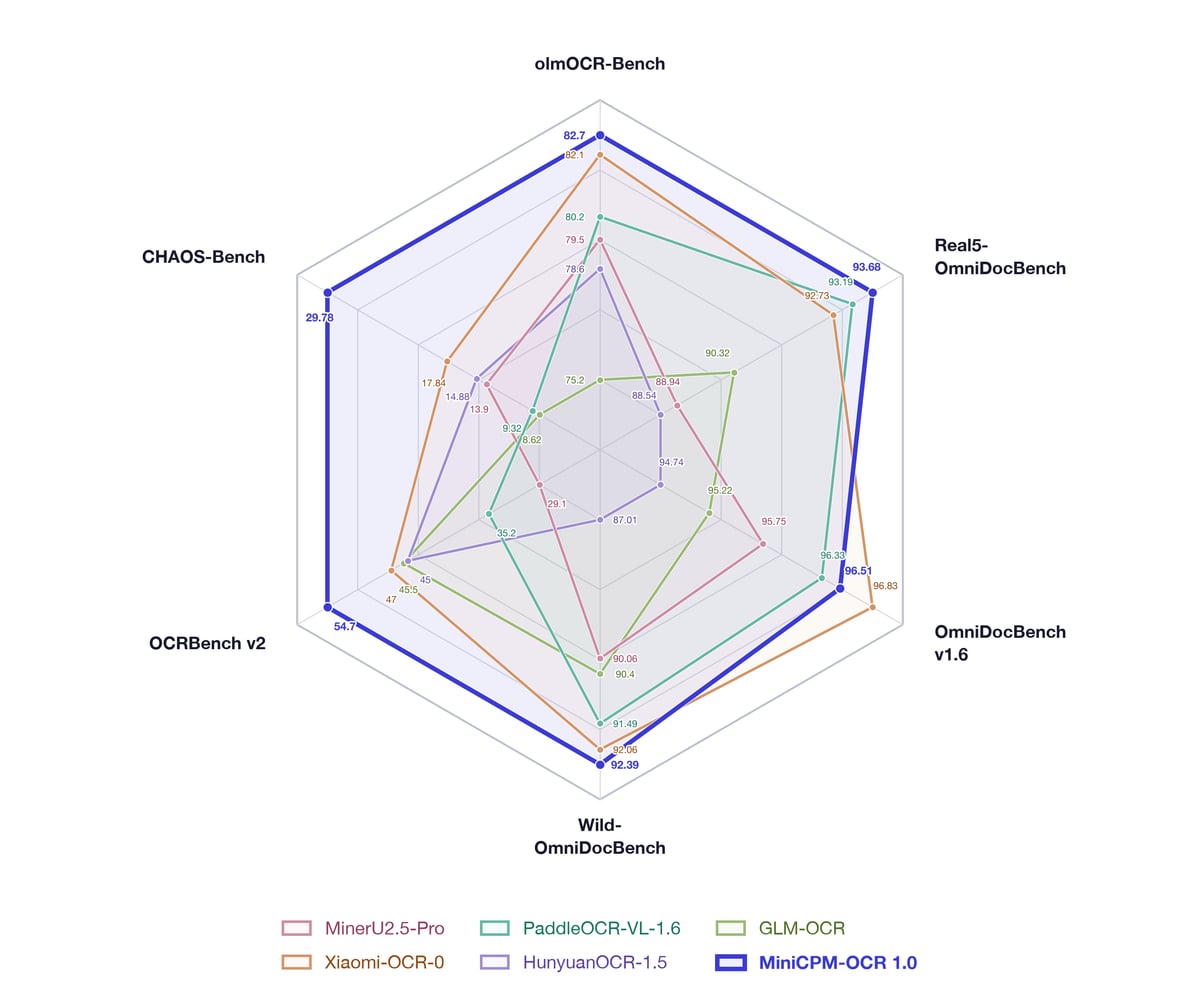
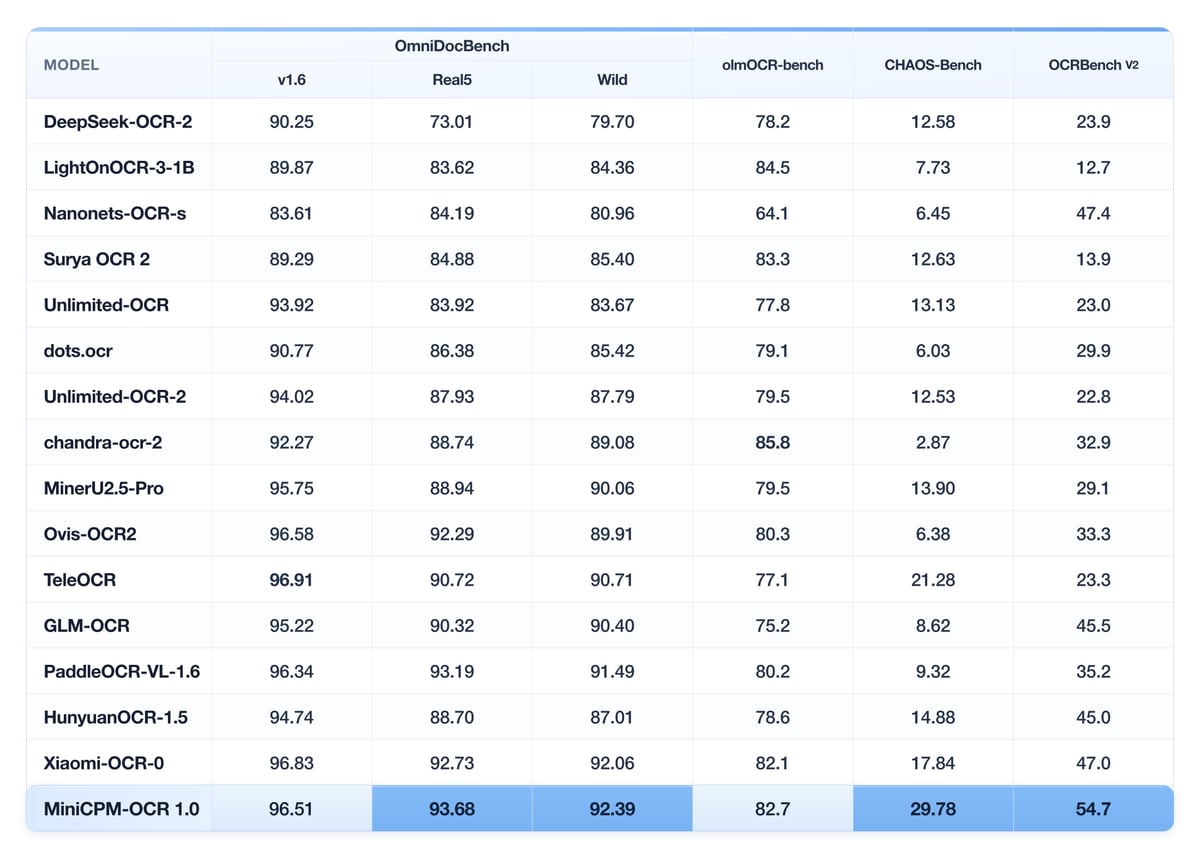
Điểm khác biệt nằm ở benchmark. MiniCPM-OCR 1.0 đạt 93.68 trên Real5-OmniDocBench, được README gọi là SOTA cho benchmark parse tài liệu thực tế. Trên OCRBench v2 nó đạt 54.7. Nó cũng dẫn đầu trên OmniDocBench v1.6, Wild-OmniDocBench, và olmOCR-Bench theo tuyên bố của repo.
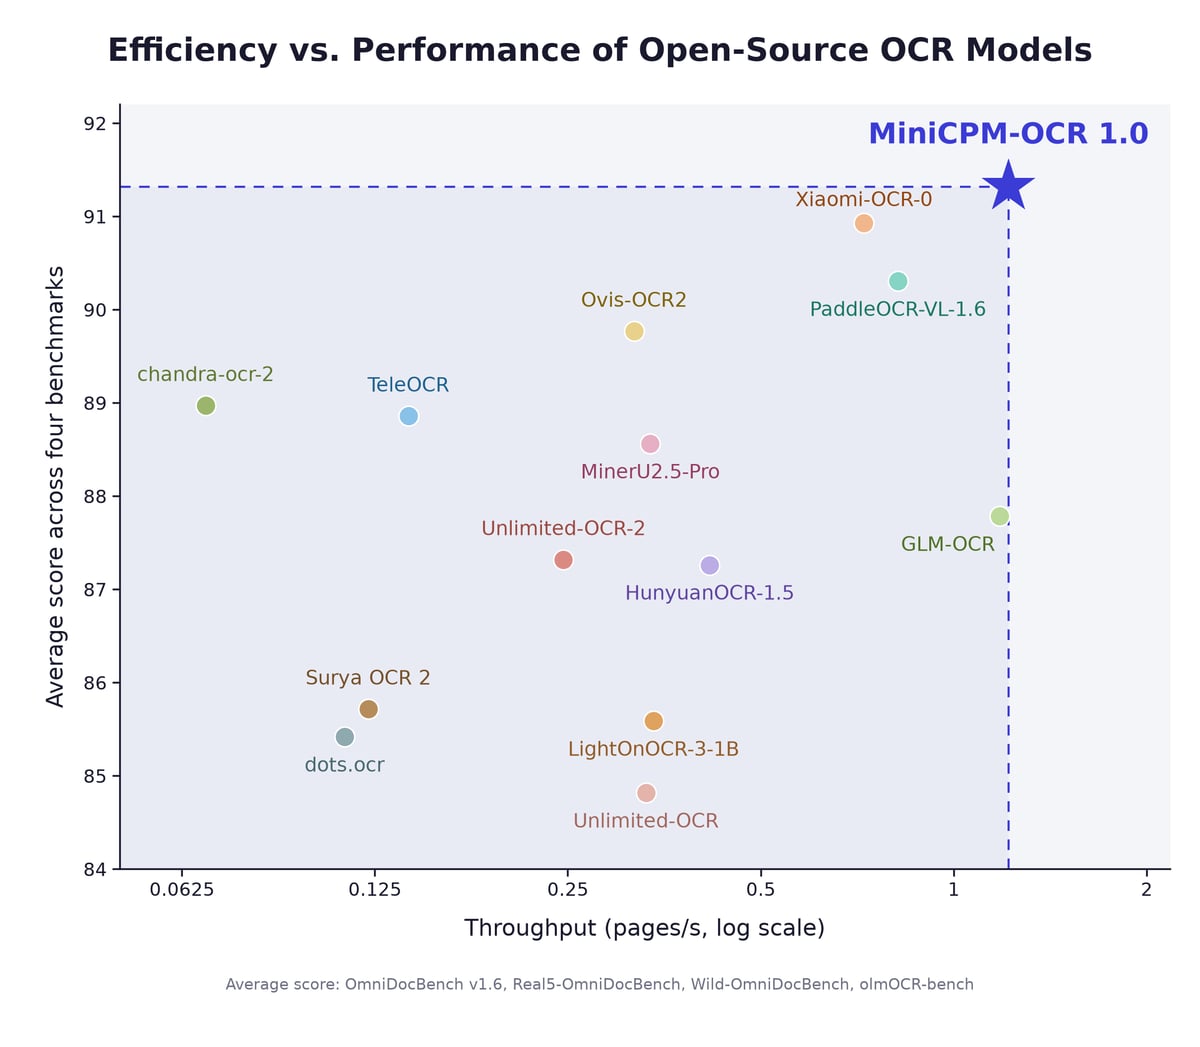
Về tốc độ, con số cụ thể: 1.2 pages/s, throughput khoảng 1.49 lần PaddleOCR-VL-1.6 và 3.62 lần MinerU2.5 Pro. DSpark decoding (bản BF16 và GGUF) cải thiện hiệu suất end-to-end 55%. Đây là những con số đáng để đối chiếu nếu bạn đang cân nhắc thay pipeline cũ.
Còn Jev thì gây tò mò hơn. Model 2B đạt AUROC (×100) 93.6 trên JevOCRBench, vượt JEV-35B-A3B (90.1) và tiệm cận Qwen3.5-397B-A17B (93.8). Một model nhỏ hơn hàng chục lần mà gần bằng model khổng lồ, đó là lý do dân làm document pipeline đang chia sẻ repo này.
Cài đặt và dùng thử nhanh
README không đưa lệnh cài đặt pip cụ thể trong phần bị cắt, nhưng có hướng dẫn dùng skill với coding agent. Cách nhanh nhất là để agent tự đọc hướng dẫn và làm theo. Với MiniCPM-OCR 1.0:
Read and execute https://github.com/OpenBMB/MiniCPM-OCR/blob/main/docs/SKILL_en.mdVới MiniCPM-OCR Jev (deploy, start, verify scoring service, chạy được từ Docker image hoặc SDK, backend là vLLM, SGLang, llama.cpp, hoặc Ollama):
Read and execute https://github.com/OpenBMB/MiniCPM-OCR/blob/main/docs/SKILL_jev_en.mdNếu đã clone repo về máy thì dùng đường dẫn local, khỏi cần mạng:
./docs/SKILL_en.md
./docs/SKILL_jev_en.md
Ngoài ra repo có sẵn Free API cho cả hai model (recognition và quality scoring), tiện để thử trước khi tải weights về. Có pip SDK và full-featured API cho ai muốn nhúng vào ứng dụng. Về backend inference, README ghi hỗ trợ vLLM, SGLang, llama.cpp và Ollama ngay từ ngày đầu, kèm nhiều phiên bản lượng tử hóa cho các nền chip khác nhau.
Ai nên dùng, dùng vào việc gì
Rõ ràng nhất là các team làm xử lý tài liệu số: hóa đơn, hợp đồng, báo cáo scan, sách cũ. Nếu bạn đang build pipeline RAG cho tài liệu PDF tiếng Trung hoặc tiếng Anh, model 1.0 đáng thử. Nếu bạn đã có pipeline OCR ổn nhưng thiếu bước QA, Jev là phần bổ sung độc lập, không cần đổi model parse.
Ai làm back-office tự động hóa cũng hưởng lợi: thay vì review 100% tài liệu, đặt ngưỡng Jev, chỉ review phần dưới ngưỡng. README có phần “Review-Free Accuracy” đo độ chính xác ở các mức review-free rate khác nhau, kèm lời khuyên đặt ngưỡng sau khi thử trên một batch nhỏ từ ứng dụng thật. Đây là lời khuyên thực dụng, không phải con số đẹp để marketing.
Người không nên dùng: ai cần OCR tiếng Việt chuyên sâu. README chỉ nêu tiếng Trung và tiếng Anh. Đừng kỳ vọng nó xử lý tốt dấu tiếng Việt nếu chưa tự test.
So sánh nhanh
README có so sánh trực tiếp với vài cái tên quen thuộc. Throughput của MiniCPM-OCR 1.0 gấp khoảng 1.49 lần PaddleOCR-VL-1.6 và 3.62 lần MinerU2.5 Pro. Jev thì vượt JEV-35B-A3B về AUROC và gần Qwen3.5-397B-A17B. Về benchmark parse, nó so với chính các model đó trên OmniDocBench v1.6 và các bộ khác. Tôi chưa tự chạy reproduction nên chỉ ghi lại con số repo công bố, bạn nên xem reproduction guide trước khi tin tuyệt đối.
Điểm khác biệt cấu trúc so với phần lớn lựa chọn khác: có model chấm điểm độc lập. PaddleOCR, MinerU, hay các VL model lớn thường trả kết quả mà không kèm confidence ở mức vùng theo cách dùng được ngay. Đó là khoảng trống Jev nhắm vào.
Ưu điểm, hạn chế, lưu ý
Ưu điểm: Model nhỏ (1.3B và 2B), chạy local được, hỗ trợ nhiều backend inference và nhiều nền chip ngay từ release. Có Free API để thử trước. Có pip SDK, có tài liệu SKILL cho agent, tức là team nào dùng coding agent sẽ setup nhanh. Benchmark công bố rõ ràng, có reproduction guide. License Apache-2.0, thoải mái dùng thương mại.
Hạn chế: Ngôn ngữ chỉ Trung và Anh, đây là giới hạn cứng nếu bạn làm thị trường Việt Nam. Repo mới 3 ngày tuổi, cộng đồng chưa đông, chưa có nhiều bài viết thực chiến hay issue report đáng tin. Tài liệu chủ yếu nằm trong docs của repo, README bị cắt ở phần Local Deployment nên tôi chưa thấy toàn bộ hướng dẫn deploy thủ công. TypeScript là ngôn ngữ chính, nhưng model chạy bằng Python backend, nên đừng nhầm repo là thư viện TS thuần.
Cần lưu ý: Con số benchmark là của tác giả công bố, chưa có bên thứ ba kiểm chứng độc lập. Ngưỡng Jev phải tune trên dữ liệu thật của bạn, đừng copy ngưỡng từ demo. Và nếu tài liệu của bạn là tiếng Việt, hãy test trên 50-100 trang trước khi đưa vào production, đừng tin vào việc model đa ngôn ngữ sẽ tự lo.
Kết luận thực dụng
Với 547 sao sau 3 ngày và benchmark 93.68 trên Real5-OmniDocBench, MiniCPM-OCR đáng để bạn bỏ 30 phút chạy thử Free API trên đúng loại tài liệu mình đang xử lý. Nếu kết quả ổn và bạn cần bước QA tự động, Jev với AUROC 93.6 ở mức 2B tham số là lựa chọn hiếm có. Còn nếu tài liệu chủ yếu là tiếng Việt, khoan hẵng, chờ thêm hoặc tự test kỹ. Repo ở đây: OpenBMB/MiniCPM-OCR.