EAGLE-4 vừa lên GitHub ngày 20/10/2026, được 644 sao ngay trong ngày đầu. Repo là inference code chính thức của EAGLE-4, thế hệ mới nhất trong họ EAGLE chuyên tăng tốc suy luận LLM bằng speculative decoding. Điểm cốt lõi: một drafter duy nhất tự điều chỉnh chiến lược speculative decoding theo batch size, phần cứng và workload đang chạy, đồng thời giữ nguyên phân phối output của model gốc.
Nó giải quyết bài toán gì
Speculative decoding vốn khó dùng vì mỗi cấu hình triển khai lại cần một drafter riêng. Batch 1 thì cần cây draft nông, batch 64 thì cần cây khác. Đổi GPU từ B300 sang MI355X cũng phải tune lại. EAGLE-4 gom hết việc đó vào một drafter: nó đo chi phí draft và verify thực tế trên batch size, hardware, workload hiện tại rồi tự quyết định kích thước speculative tree.
Về kiến trúc, draft dùng sliding-window draft layer, một low-rank candidate head và append-only draft cache. Repo implement cả hai dạng draft là dense và latent-MoE. Cặp target model được đo đạc trong release này là Qwen3.8-27B với draft EAGLE-4 tương ứng.
Phần engine là eagle_harness, package pip cài được, serve draft EAGLE-4 trên SGLang, vLLM và TokenSpeed qua engine plugin. Nó đăng ký qua các hook mà engine mở ra, không patch engine lúc runtime. Các engine đã vá được phát hành dưới dạng wheel pin sẵn và container image, không đưa source tree vào repo này.
Vì sao dân dev quan tâm
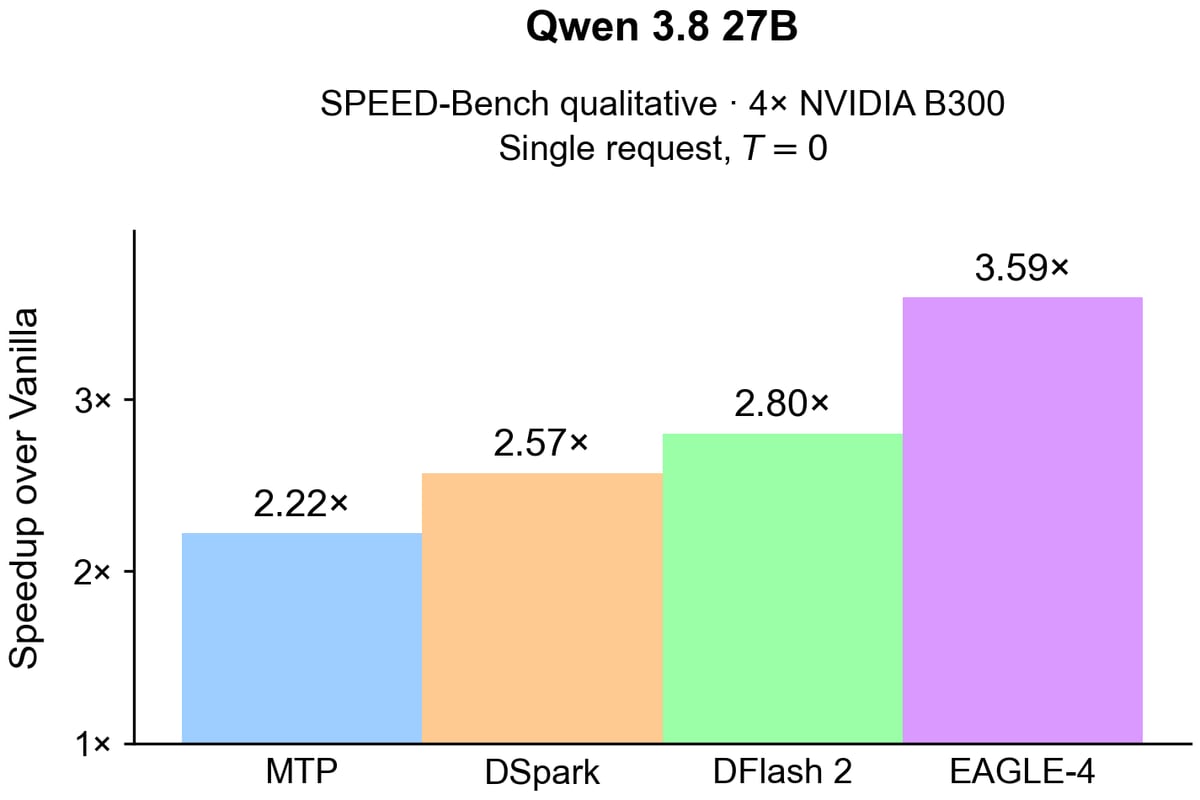
Bảng kết quả đo trên SPEED-Bench client, temperature 0, trung bình hai lần khởi động server, là lý do chính:
- SGLang, 4× B300 TP4, concurrency 8: 1479.4 token/s không spec lên 2820.6 token/s, tức 1.91×.
- SGLang, 4× B300 TP4, concurrency 64: 3925.3 lên 5281.3 token/s, 1.35×.
- SGLang, 1× MI355X TP1, concurrency 8: 552.7 lên 1145.9 token/s, 2.07×.
- SGLang, 1× MI355X TP1, concurrency 32: 1269.2 lên 1980.8 token/s, 1.56×.
- vLLM, 4× B300 TP4, concurrency 1: 241.6 lên 722.8 token/s, 2.99×.
- vLLM, 4× B300 TP4, concurrency 8: 1699.9 lên 2883.9 token/s, 1.70×.
Con số 2.99× ở batch 1 của vLLM là thứ đáng để thử, vì batch nhỏ thường là chỗ speculative decoding khó ăn nhất. Bên cạnh đó repo có mặt trên cả NVIDIA B300 (CUDA 13.0) lẫn AMD MI355X (ROCm 7.2), điều hiếm thấy ở các dự án speculative decoding. TokenSpeed thì mới ở mức experimental, chỉ CUDA, và README nói thẳng là không claim throughput nào cho TokenSpeed.
Cài và chạy thử
Clone repo rồi source file pin phiên bản. Lưu ý chạy lệnh từ thư mục chứa checkout, vì bên trong đó python -m sẽ import source tree eagle_harness/ thay vì wheel đã cài.
git clone https://github.com/eagle-hq/EAGLE-4
. EAGLE-4/docs/release.env
SGLang trên CUDA, dùng Python 3.12:
python3.12 -m venv .venv-sglang && source .venv-sglang/bin/activate
python -m pip install --upgrade pip
python -m pip install --extra-index-url "$EAGLE_CUDA_INDEX" \
 --extra-index-url "$EAGLE_TORCH_CUDA_INDEX" "sglang==$EAGLE_SGLANG_VERSION" 'flashinfer-python>=0.7.2'
python -m pip install "eagle-harness==$EAGLE_VERSION"
eagle-harness-check
Hoặc mở thẳng release image đã có engine và EAGLE-4:
docker run --rm --gpus all --ipc host -it \
 -p 127.0.0.1:30000:30000 -v "$PWD/models:/models:ro" \
 --entrypoint bash "$EAGLE_SGLANG_IMAGE"
eagle-harness-check
eagle-harness-check trả về exit code 0 khi engine đã cài cung cấp đủ hook mà plugin cần. Nó không chứng minh kernel chạy được hay generation đúng, nên phải gửi request quickstart trước khi đo bất cứ thứ gì. Lệnh serve Qwen3.8-27B BF16 trên 4 GPU B300 với SGLang nằm đầy đủ trong quickstart, gồm cả --speculative-algorithm EAGLE_HARNESS và --speculative-draft-model-path "$DRAFT".
Với ROCm thì dùng Python 3.10 cho wheel MI355X. TokenSpeed cần scheduler và kernel wheel từ cùng index.
Ai nên dùng
Team đang self-host LLM inference và đã có sẵn SGLang hoặc vLLM trong stack. Nếu bạn đang trả tiền cho 4 con B300 mà throughput batch 1 chỉ loanh quanh 241 token/s trên vLLM, đây là thứ đáng benchmark thử. Còn nếu workload cố định một batch size, một loại GPU, một model từ lâu rồi, thì lợi ích của “one drafter cho mọi thứ” ít hơn, và việc pin thêm một bộ wheel đã vá có thể không đáng.
Người dùng AMD MI355X nên để ý: đây là một trong số ít dự án speculative decoding đo đạc công khai trên ROCm, dù image cho MI355X chưa publish, phải tự build.
So với lựa chọn khác
Trong cùng không gian, có các implementation speculative decoding gắn chặt với từng engine (chẳng hạn Medusa hay draft model kiểu truyền thống). Khác biệt ở đây là EAGLE-4 nhắm tới tính linh hoạt theo batch và hardware, cộng với việc tách phần harness ra thành package riêng để chạy trên nhiều engine. Tôi chưa thấy dự án nào cùng họ công bố bảng đo trên cả NVIDIA lẫn AMD với cùng một drafter, nên so sánh trực tiếp thì phải tự benchmark trên workload của mình.
Ưu điểm và những chỗ cần cân nhắc
Ưu điểm rõ: một drafter cho nhiều cấu hình, có kết quả đo kèm điều kiện cụ thể, hỗ trợ SGLang và vLLM, đường cài bằng container image khá gọn, và cơ chế hook thay vì patch runtime giúp việc nâng cấp engine bớt đau.
Hạn chế thì cũng rõ không kém. License ghi là không rõ, đây là điểm chặn với nhiều team trước khi đưa vào production. Repo mới tạo ngày 20/10/2026, cùng ngày cập nhật, tức là cực non, chưa có lịch sử issue hay PR để đánh giá độ ổn định. Bạn phải dùng đúng wheel engine đã vá, không phải bản stock, nên bị khoá theo phiên bản cụ thể. Cặp model được đo chỉ có Qwen3.8-27B, chưa có số liệu cho model khác. TokenSpeed chưa có throughput công bố. Và cái check cài đặt chỉ xác nhận hook tồn tại, không xác nhận generation đúng, nên quy trình test của bạn phải tự lo phần correctness. README có nhắc: lệch greedy không giải thích được sẽ fail correctness gate kể cả khi server nhanh hơn.
Cá nhân tôi thấy con số 1.91× trên SGLang batch 8 và 2.99× trên vLLM batch 1 đủ để bỏ một buổi chiều benchmark. Nhưng 644 sao trong ngày đầu, với một repo chưa có gì ngoài release 0.1.0, là kiểu tín hiệu cần đọc kèm thực nghiệm chứ đừng tin ngay. Cứ clone về, chạy eagle-harness-check, gửi request quickstart, rồi đo trên chính workload của bạn trước khi quyết định gắn bó. Repo: eagle-hq/EAGLE-4.